NoSQL ve
MongoDB
Bugün neler konuşacağız?
- 01Büyük veri ve veri bilimindeki yeri
- 02İlişkisel veritabanları neden zorlandı?
- 03NoSQL'in kısa tarihi
- 04NoSQL türleri ve teorisi
- 05MongoDB nasıl çalışır?
- 06Projemiz: ölçümler ve canlı uygulama
Veri bilimi, verinin nerede durduğuyla başlar.
Topla
Uygulama, sensör, log
Sakla
Veritabanı
Temizle
Hatalı kaydı ayıkla
Analiz et
Özet, grafik
Modelle
Tahmin, karar
Bu sunum ikinci adımla ilgili: veri büyüyünce onu nerede ve nasıl saklarız?
Dünyadaki veri 15 yılda 90 kat büyüdü.
1 zettabayt = 1 milyar terabayt · Kaynak: IDC, Statista
Bir şehir, bir ay: 3 milyon yolculuk.
Ocak 2024'te sadece New York sarı taksileri
Gece gündüz durmadan yeni kayıt
Zaman, konum, mesafe, ücret, ödeme…
Hatalı kayıt. Negatif ücretler bile var
En yoğun saat. Talep tahmini buradan çıkar
Veri o kadar büyüdü ki geleneksel sistemler zorlanmaya başladı.
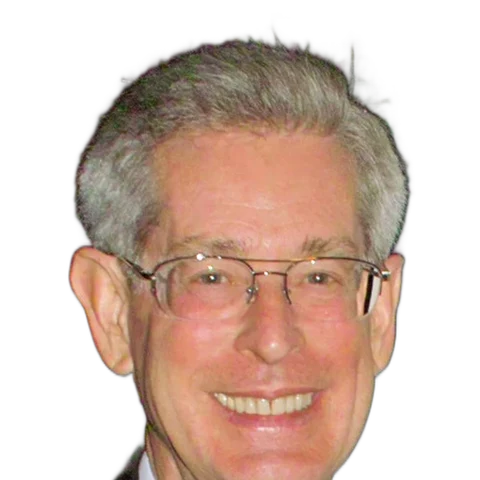
1970: Veriyi tablolara koymak.
Edgar F. Codd
IBM · 1970
"A Relational Model of Data for Large Shared Data Banks" makalesiyle ilişkisel modeli tanımladı. 1981 Turing Ödülü.
Donald Chamberlin
IBM · 1974
Raymond Boyce ile birlikte SEQUEL'i, bugünkü SQL'in atasını tasarladı.
Satır, sütun, şema ve JOIN.
SQL neden 50 yıl dayandı?
Standart dil
ANSI standardı. Bir kez öğren, her veritabanında kullan.
Güvenilir
Para transferi yarıda kalmaz.
İlişki kurar
Dağınık veriyi tek sorguda birleştirir.
Olgun
Oracle, MySQL, PostgreSQL. Yıllarca test edildi.
Veri büyüyünce tablolar zorlanıyor.
Katı şema
Yeni bir sütun eklemek, 2,8 milyon satırı tek tek güncellemek demek. Bizim ölçümümüz.
Dikey ölçekleme
Yük artınca daha güçlü sunucu alırsın. Pahalı, ve bir tavanı var.
JOIN maliyeti
Tablolar farklı makinelere bölününce JOIN ağ üzerinden yapılır.
Yapısız veri
Log, JSON, sensör verisi: her kaydın şekli farklı.
Tek sunucunun bir tavanı var.
İki kat güçlü sunucu, iki kattan çok daha pahalı.
Bir makineye takılabilecek işlemci ve bellek sınırlı.
O sunucu düşerse her şey durur.
"NoSQL" kelimesi ilk kez kullanılıyor.
Carlo Strozzi
İtalya · 1998
SQL arayüzü olmayan küçük bir ilişkisel veritabanına "NoSQL" adını verdi. Bugünkü anlamıyla ilgisi yoktu; terim 11 yıl sonra geri dönecekti.
Google bütün interneti tek makineye sığdıramıyordu.
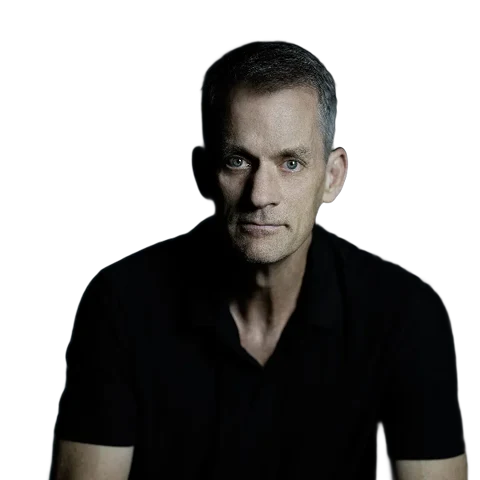
Jeff Dean
Sanjay Ghemawat ile MapReduce (2004) ve Bigtable (2006) makalelerini yazdı.
Binlerce ucuz sunucuya dağılan dev bir tablo.
HBase ve Cassandra'ya ilham verdi.
Amazon: "Sepete ekle" butonu asla hata vermemeli.
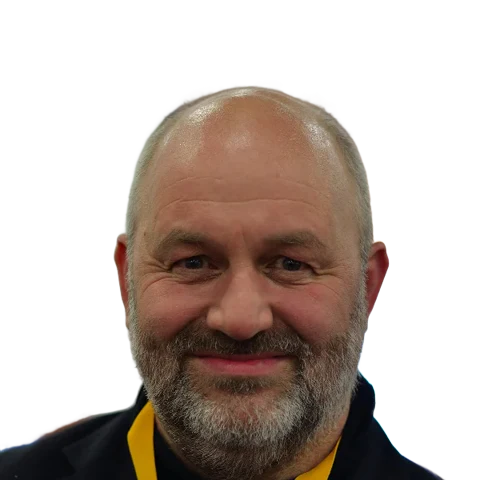
Werner Vogels
Amazon CTO
Ekibiyle Dynamo makalesini yayınladı.
Tutarlılıktan biraz vazgeç, her zaman yazılabilir ol.
Bir sunucu çökse bile müşteri sepetine ürün ekleyebilmeli.
Fikirler açık kaynağa dönüştü, isim yerleşti.
Cassandra
Facebook, Dynamo + Bigtable fikirleri
MongoDB
10gen, doküman veritabanı
Redis
Bellekte anahtar-değer
#nosql
Johan Oskarsson'un San Francisco buluşması; terim yayılır
Not Only SQL.
SQL'in rakibi değil, tamamlayıcısı.
Esnek şema
Her kayıt kendi alanlarını taşır.
Yatay ölçekleme
Yük artınca makine eklenir.
Dağıtık yapı
Veri birçok sunucuya bölünür.
Esnek şema: aynı koleksiyon, farklı kayıtlar.
{
  pickup:  "JFK Airport",
  fare:    52.3,
  passengers: 1
}
{
  pickup:  "Harlem",
  fare:    18.2,
  passengers: 2,
  weather: "yağmurlu",
  nickname: "Emir"
}
İkinci kayıtta iki yeni alan var. Tabloyu değiştirmeye gerek yok.
Tek bir NoSQL yok. Dört farklı model var.
Document
MongoDBÜrün kataloğu, içerik
Key-Value
RedisÖnbellek, oturum, sepet
Column-Family
CassandraIoT, zaman serisi, log
Graph
Neo4jSosyal ağ, öneri sistemi
Doküman ve anahtar-değer.
{ _id: 1042,
  name: "Kulaklık",
  price: 899,
  specs: { kablosuz: true, pil: "30 saat" } }
Her ürün kendi özelliklerini taşır. Ayakkabının bedeni, laptopun RAM'i.
session:4821→{ user: "emir", sepet: 3 }views:urun:1042→15 208kur:USD→41,2Anahtarı bil, değeri milisaniyede al. Önbellek ve oturum için.
Geniş sütun ve graf.
Bir satır anahtarının altında binlerce sütun. Sürekli yazılan sensör ve log verisi için.
İlişkinin kendisi veri. "Arkadaşımın arkadaşı kim?" sorusu anında cevaplanır.
SQL ve NoSQL, yan yana.
Tablo, satır, sütun
Doküman, anahtar-değer, sütun, graf
Sabit, önceden tanımlı
Esnek
Dikey: daha güçlü sunucu
Yatay: daha çok sunucu
Standart SQL
Veritabanına özgü
ACID
BASE, ayarlanabilir
Banka, muhasebe, ERP
Katalog, IoT, log, analitik
Ağ koptuğunda bir seçim yapmak zorundasın.
Tutarlılık · Erişilebilirlik · Bölünme toleransı
Eric Brewer · 2000
UC Berkeley. Dağıtık sistemde üçü aynı anda olmaz.
CP · tutarlı kal
Gerekirse bekle ya da hata ver. MongoDB
AP · cevap ver
Veri birkaç saniye eski olabilir. Cassandra
ACID ve BASE: iki farklı söz.
Banka transferi
- Atomicity: ya hepsi ya hiçbiri
- Consistency: kurallar hep geçerli
- Isolation: işlemler birbirini görmez
- Durability: yazılan kaybolmaz
Beğeni sayacı
- Basically Available: her zaman cevap ver
- Soft state: durum değişebilir
- Eventual consistency: sonunda herkes aynı sayıyı görür
Büyütmek mi, bölmek mi?
Dikey
Tek makineyi büyüt.
Yatay
Yeni makine ekle.
Sharding
Veriyi böl: her sunucu farklı bir parçayı tutar.
Replication
Veriyi kopyala: her sunucu aynısını tutar.
MongoDB: humongous, yani devasa.
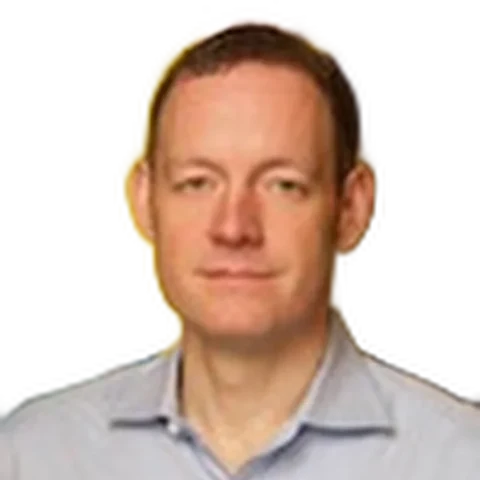
Dwight Merriman
Kurucu
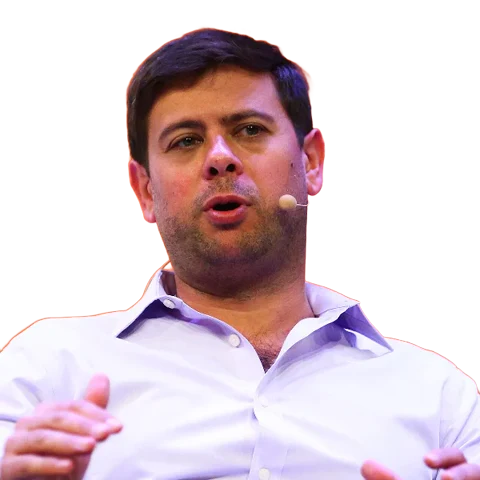
Eliot Horowitz
Kurucu, CTO
Veri MongoDB'de nasıl durur?
Kayıtlar BSON olarak saklanır: tarih ve sayı tiplerini de taşıyan ikili JSON.
Aynı yolculuk: üç tablo ya da tek doküman.
1042 · 132 · 236 · 99.40 · 1132 · JFK Airport · Queens1 · cardSELECT … JOIN zones … JOIN zones … JOIN payment_types
{
  pickup:  { zone: "JFK Airport", borough: "Queens" },
  dropoff: { zone: "Upper East Side", borough: "Manhattan" },
  passengers: 1,
  fare: { total: 99.4, payment: "card" }
}
Göm mü, referans mı ver?
{ zone: "JFK Airport",
  borough: "Queens" }
Ne zaman: Birlikte okunan, az değişen veri. Okuma tek seferde.
Bedeli: aynı bilgi binlerce kez tekrarlanır.
{ zone_id: 132 } // zones koleksiyonundaNe zaman: Çok büyüyen ya da sık değişen veri. $lookup ile birleştirilir.
Bedeli: okurken ikinci bir sorgu.
Kural: "Birlikte okunan birlikte saklanır." · Bir doküman en fazla 16 MB
Aynı iş, iki dil.
INSERT INTO trips … VALUES (…)
db.trips.insertOne({ … })SELECT * FROM trips WHERE total > 50
db.trips.find({ "fare.total": { $gt: 50 } })UPDATE trips SET tip = 10 WHERE …
db.trips.updateOne({ … }, { $set: { … } })DELETE FROM trips WHERE …
db.trips.deleteMany({ … })GROUP BY'ın karşılığı: bir boru hattı.
Hangi ilçede kartla ödeyenler daha çok bahşiş bırakıyor?
yolculuk
kartla ödenen
ilçe
- Manhattan %23,9
- Queens %20,5
- Staten Island %13,0
Doğru indeks: 70 kat fark.
2.839.623 doküman tek tek okundu
sadece 2.343 doküman okundu
Sorgu: 15 Ocak, 08:00–09:00 arası yolculuklar · demoda canlı
Replica set: bir sunucu düşse de sistem ayakta.
1 Her yazma primary'ye gider.
2 Secondary'ler değişiklikleri oplog üzerinden kopyalar.
3 Primary düşerse kalanlar oylar, yeni primary saniyeler içinde seçilir.
Ne zaman MongoDB, ne zaman değil?
Uygun
- İçerik yönetimi
- Ürün kataloğu
- IoT ve log
- Gerçek zamanlı analitik
- Mobil uygulama arka ucu
Dikkat
- Bankacılık, muhasebe
- Çok tablolu sıkı tutarlılık
- Yoğun JOIN'li raporlar
MongoDB 4.0'dan beri çok dokümanlı ACID transaction da var.
Büyük veri ekosisteminde nerede duruyor?
Toplama
Uygulama, IoT, Kafka
Depolama
MongoDB, veri gölü
Özetleme
Aggregation
Analiz
pandas, Spark
Sonuç
Model, dashboard
Spark Connector ile Hadoop/Spark'a bağlanır · Kafka Connector ile akan veriyi alır
Biz ne yaptık?
Veriyi aldık
NYC TLC, Ocak 2024: 2.964.624 yolculuk
Temizledik
Python ile 125.001 hatalı kayıt ayıklandı
Dağıttık
MongoDB, 3 shard; şimdilik tek bilgisayarda simüle
Ölçtük
Aynı veri PostgreSQL'de de: 9 farklı test
Uygulama yaptık
Canlı panel, sorgu laboratuvarı, telefondan veri ekleme
2,8 milyon yolculuk, 3 shard, 1 bilgisayar.
Ölçtük: kim, nerede hızlı?
NoSQL, SQL'in yerine geçmez.
Onu tamamlar.
NoSQL ölçek sorunundan doğdu.
JOIN'de SQL, esnek veri ve yatay ölçekte MongoDB.
Dağıtmak güç verir ama bir bedeli var.
Şimdi sıra sizde.
QR'ı okutun, bir taksi yolculuğu ekleyin. Kaydınızın üç sunucudan hangisine gittiğini göreceksiniz.
Kahoot!
10 soru, 20'şer saniye.
Teşekkürler. Sorular?
- Codd, A Relational Model of Data…, 1970 · Chamberlin & Boyce, SEQUEL, 1974
- Dean & Ghemawat, MapReduce, 2004 · Chang ve ark., Bigtable, 2006
- DeCandia ve ark., Dynamo, 2007 · Brewer, CAP, 2000
- Kleppmann, Designing Data-Intensive Applications, 2017
- IDC / Statista veri hacmi tahminleri · MongoDB Docs · NYC TLC Trip Record Data
- Fotoğraflar: Wikimedia Commons · Cmichel67 (CC BY-SA 4.0), Raysonho (CC0), Vera de Kok (CC BY-SA 4.0), Megaltoid (CC BY-SA 3.0), Collision Conf (CC BY 2.0), Dicklyon (CC BY-SA 4.0)